Ecossistema operacional com Ansible, Semaphore, n8n e Zabbix
Plataforma operacional própria que transforma playbooks, alertas e diagnósticos em operações governadas, com alvo explícito, classificação de risco, confirmação, rate limit e validação de resultado.
O problema não era falta de Ansible #
Ansible já resolvia boa parte da repetição técnica.
O gargalo aparecia depois:
| |
Se toda resposta depende da mesma pessoa abrir terminal, localizar a receita certa e executar manualmente, existe automação no código — mas a operação continua concentrada.
O projeto evoluiu justamente nessa camada.
O Semaphore virou o control plane de execução. n8n passou a orquestrar decisões e integrações. Zabbix deixou de ser apenas origem de alertas em alguns fluxos e passou a alimentar diagnóstico e automação contextual. O Ansible continuou responsável pela execução reproduzível no alvo.
O resultado é melhor entendido como um ecossistema:
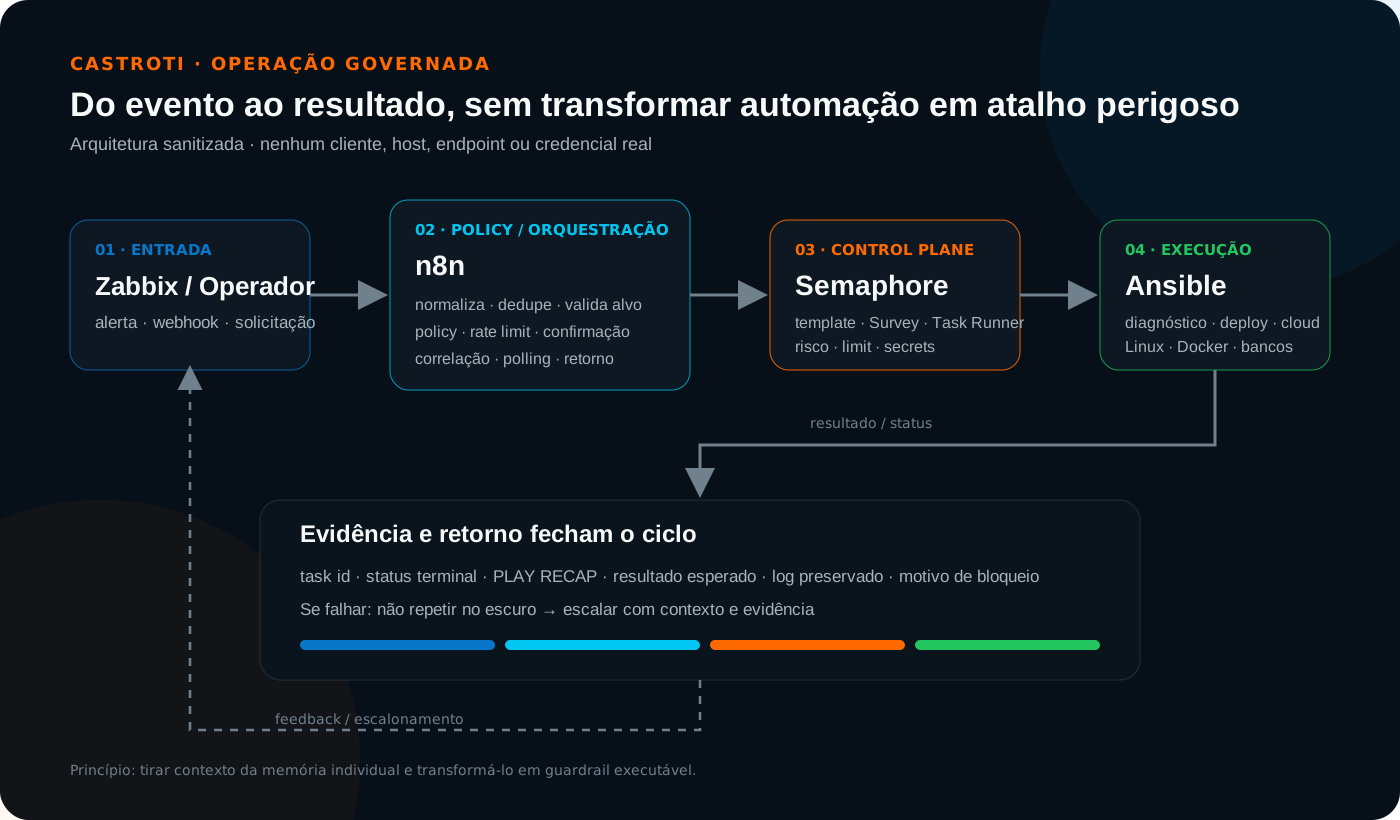
| |
Objetivo operacional #
A meta não é entregar um shell remoto mais bonito.
É permitir que rotinas conhecidas sejam executadas por uma camada operacional controlada sem transformar acesso SSH e conhecimento interno do playbook em pré-requisitos para cada tarefa cotidiana.
Para isso, a plataforma precisa encapsular mais do que comandos:
- intenção da operação;
- alvo;
- parâmetros permitidos;
- risco;
- blast radius;
- credenciais;
- validação;
- estado da execução;
- evidência de sucesso/falha;
- critério de escalonamento.
O Semaphore é o núcleo de execução #
A stack privada de referência é self-hosted e possui:
| |
O executor foi preparado para operar diferentes classes de infraestrutura sem exigir uma VM manual diferente para cada tipo de tarefa.
AWS e OCI entram por configuração montada em modo read-only; secrets e runtime ficam fora do Git.
O repositório operacional continua privado #
O repositório real contém contexto de operação e referências que não devem ser transformadas em exemplo público diretamente.
A regra do CastroTI é:
| |
Nunca transformar o repositório-fonte em demo apagando nomes ou secrets “no lugar”.
Antes de liberar, classificar #
Um dos princípios mais importantes do projeto foi não reorganizar fisicamente todos os playbooks antes de entender o que já existia.
O método documentado é:
| |
Isso preserva comportamento conhecido enquanto a governança é construída.
Risco LOW / MEDIUM / HIGH / DANGER #
O catálogo usa uma classificação operacional simples:
| |
A classificação não substitui revisão do código.
Ela existe para que a interface operacional carregue a noção de risco que antes ficava apenas na cabeça de quem conhecia o playbook.
Task Runner: executar receita sem editar receita #
O modelo de operador separa execução de administração.
Um Task Runner pode executar templates disponibilizados sem precisar editar:
- repositório;
- inventory;
- variable groups;
- key store;
- templates;
- credenciais.
Isso é central para o projeto.
Automação reduz trabalho manual, mas aumenta blast radius quando o mesmo usuário consegue alterar a receita e executá-la imediatamente sobre muitos alvos.
A separação reduz esse espaço de improviso.
Surveys viram contrato da operação #
Em vez de pedir que o operador saiba quais -e, arquivos ou parâmetros internos passar ao Ansible, o template expõe apenas variáveis necessárias.
Exemplos de campos usados ou previstos:
| |
Para quem executa, isso é interface.
Para quem mantém a plataforma, isso é um contrato operacional versionável.
Limit protege o blast radius #
Uma das regras recorrentes do runbook é tornar o alvo explícito.
Em um inventory amplo, esquecer o limitador pode significar executar a receita em mais hosts do que o pretendido.
Por isso o alvo precisa aparecer antes do botão de execução e também ser validado dentro da automação sempre que possível.
A proteção ideal é em camadas:
| |
PLAY RECAP é evidência, não decoração #
O final do Ansible também virou parte do runbook.
O operador precisa distinguir:
| |
Isso é simples, mas evita transformar o botão Run em estratégia de retry.
Zabbix entra antes da execução #
Em partes do ecossistema, o fluxo começa na monitoria.
Um alerta pode chegar ao n8n e passar por:
| |
Só depois um diagnóstico automático pode seguir para o Semaphore.
Essa ordem muda bastante o papel da monitoria:
detectar não significa automaticamente remediar.
Primeiro o evento precisa ser entendido o suficiente para entrar em uma receita segura.
Diagnóstico automático não pode virar tempestade automática #
Um workflow versionado adicionou rate limiting com Redis antes do AutoDiag.
A política registrada combina:
- validação do host;
- contador diário por alvo;
- intervalo mínimo entre diagnósticos;
- TTL do estado temporário;
- decisão explícita sobre comportamento quando Redis falha.
Isso resolve um problema que aparece quando monitoria e automação se encontram:
a operação pode estar correta, mas ser executada vezes demais.
O artigo Rate limiting antes do AutoDiag detalha essa camada.
n8n é policy e orquestração #
O n8n não substitui Ansible nem Semaphore.
Ele conecta estados que são desconfortáveis de manter dentro de um único playbook:
| |
Isso permite separar:
| |
Quando a entrada já é determinística, a IA sai do caminho #
Um dos fluxos possui um branch explícito de bypass da IA.
Se template_id e alvo já vieram estruturados e passam pelas validações, não existe motivo para pedir a um modelo que redescubra uma intenção que o sistema já conhece.
A IA fica reservada para entrada realmente não estruturada.
Isso reduz:
- latência;
- custo;
- variabilidade;
- risco de classificação errada.
O princípio está detalhado em Quando a entrada já é estruturada, tire a IA do caminho.
Confirmação humana não é um if decorativo #
Para operações que exigem confirmação, o fluxo persiste uma pendência com identidade própria.
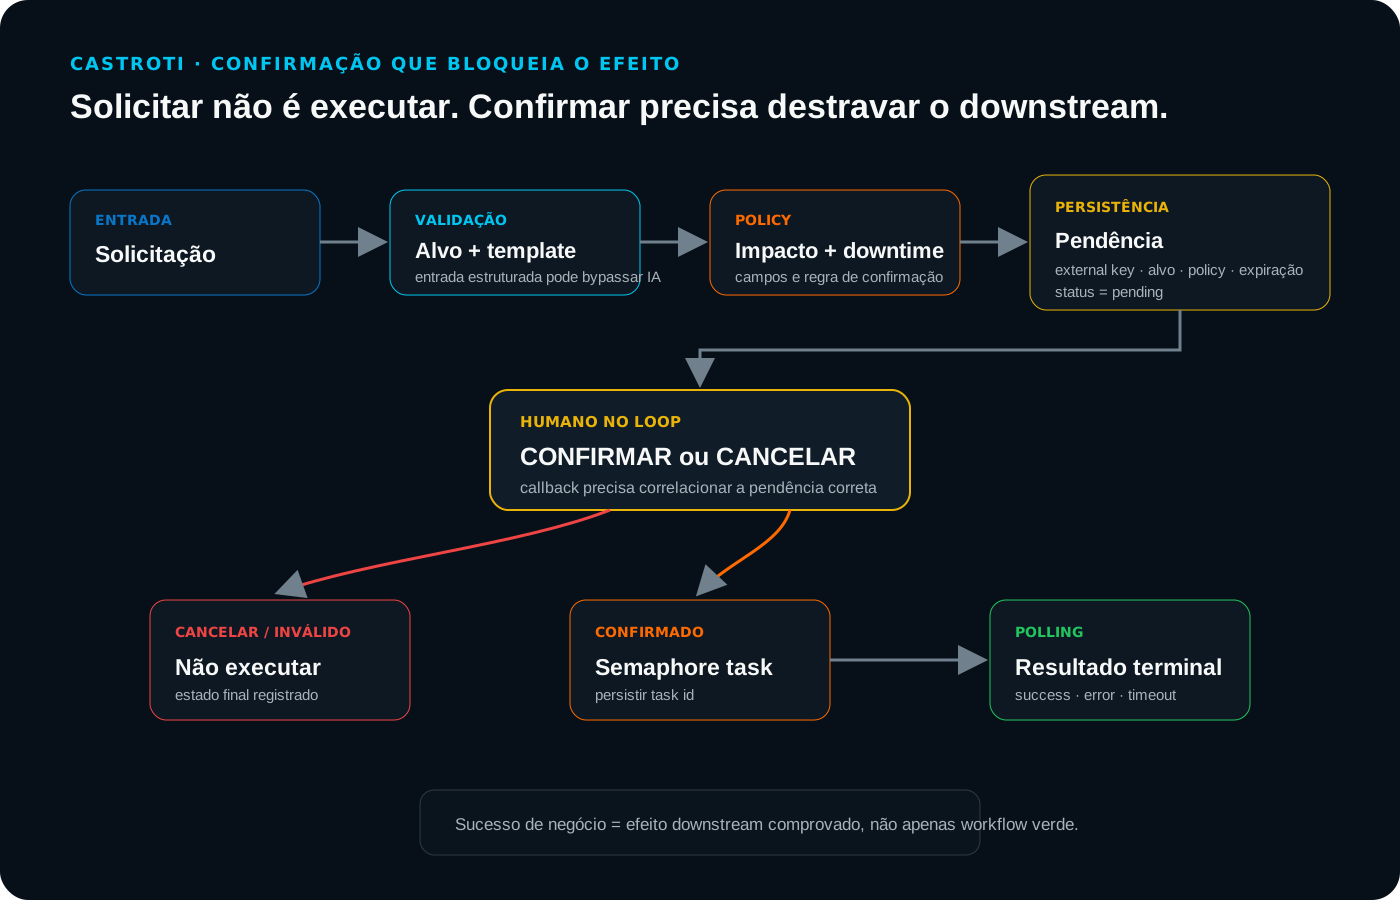
Conceitualmente:
| |
Esse desenho é diferente de simplesmente enviar uma mensagem e continuar o workflow no mesmo instante.
A confirmação precisa bloquear o efeito downstream.
Workflow verde não é operação concluída #
Outra lição veio de troubleshooting real do próprio caminho n8n → Semaphore.
Uma execução do orquestrador pode terminar Succeeded mesmo sem criar a task downstream se o fluxo tomou outro branch ou perdeu campos necessários.
Por isso o sucesso de negócio precisa de evidência própria:
| |
O artigo n8n terminou como Succeeded, mas nenhuma task nasceu no Semaphore documenta esse problema.
Polling fecha o ciclo #
Para tarefas assíncronas, criar a task é apenas o começo.
Um sub-workflow versionado consulta o estado do Semaphore periodicamente e classifica:
| |
O operador recebe o retorno sem precisar ficar alternando entre várias UIs apenas para descobrir se a execução terminou.
Famílias de automação já mapeadas #
O inventário operacional contém famílias como:
- ativação de hosts/aplicações;
- Docker/API/deploy;
- Redis;
- PostgreSQL;
- OCI;
- diagnóstico cloud;
- Zabbix;
- Promtail/logs;
- Nginx/domínio;
- health checks;
- scanner/auditoria.
Inventariado não significa liberado.
Cada receita precisa passar pelo gate de risco, variáveis, teste e permissão.
O próprio control plane precisa de guardrails #
A stack também aplica limites ao executor:
- máximo de tarefas paralelas;
- duração máxima de task;
- health check de banco;
- rede interna separada;
- debug apenas em loopback;
- secrets por arquivo;
- configuração cloud montada read-only;
- backup/restore da plataforma.
Automação crítica precisa incluir a automação no próprio modelo de recuperação.
O que mudou conceitualmente #
Antes, o conhecimento para executar uma rotina podia estar distribuído assim:
| |
Depois da evolução da plataforma, esse conhecimento passa a ser empurrado para o sistema:
| |
Esse é o ganho principal.
Não é “ter uma interface web para Ansible”.
É tirar contexto operacional da memória individual e transformá-lo em guardrail executável.
Escala #
A plataforma é usada em uma operação de frota ampla e heterogênea.
Existe uma escala operacional maior informada internamente, mas números de quantidade de servidores e percentual de demanda delegada só devem aparecer aqui quando estiverem ligados a uma medição reproduzível.
Até lá, o projeto prefere perder impacto de marketing a ganhar precisão falsa.
O que pode virar download público #
O repositório operacional continuará privado.
O derivado planejado é um Semaphore Ops Blueprint sanitizado, criado em outro repositório.
Pode incluir:
- Compose genérico;
- Dockerfile do executor;
- smoke playbooks;
- inventory de exemplo;
- taxonomia LOW/MEDIUM/HIGH/DANGER;
- Survey examples;
- modelo Task Runner;
- padrão de
limit; - backup/restore de exemplo;
- checks da stack;
- CI para lint/segredos;
- exemplos n8n sanitizados sem endpoints ou IDs reais.
Nunca incluir:
- inventory real;
- clientes;
- domínios;
- IPs;
- profiles/contas cloud;
- tokens/chaves;
- workflows exportados sem sanitização;
- playbooks específicos de cliente sem revisão.
Conteúdo relacionado #
- Inventariar antes de reorganizar playbooks
- Classificando risco LOW, MEDIUM, HIGH e DANGER
- Usando
--limitpara controlar blast radius - Rate limiting antes do AutoDiag
- n8n verde não significa downstream executado
- Bypass determinístico da IA em automação operacional
Status #
| |
Tecnologias #
Ansible · Semaphore · n8n · Zabbix · Redis · PostgreSQL · Docker · Traefik · AWS CLI · OCI CLI · SSH · Bash · Kubernetes tooling
Me chama.
Manda o contexto, os sintomas e o que já foi testado. Bora organizar as evidências antes de sair mexendo.