- Castro/
- blog/
- Rate limiting antes do AutoDiag: usando Redis para impedir que alertas repetidos disparem automação demais/
Rate limiting antes do AutoDiag: usando Redis para impedir que alertas repetidos disparem automação demais
Como um fluxo Zabbix → n8n → Semaphore usa contadores Redis, intervalo mínimo e limite diário por host antes de disparar diagnósticos automáticos.
Automatizar diagnóstico a partir de um alerta parece simples:
| |
Até o dia em que o mesmo host começa a flappar ou gera vários alertas relacionados.
Sem um guardrail, a automação que deveria reduzir trabalho pode produzir uma fila de diagnósticos repetidos no mesmo servidor.
Em um workflow operacional real, a solução foi colocar rate limiting antes da chamada ao Semaphore, usando Redis como estado compartilhado.
O desenho versionado tinha três regras principais por host:
| |
Além disso, a política era fail-open se o Redis ficasse indisponível.
Rate limit é diferente de deduplicação do alerta #
O mesmo workflow já tinha lógica para reduzir flapping e repetição de mensagens.
Mas isso resolve outro problema.
Deduplicação #
Pergunta:
Já processei/notifiquei este estado recentemente?
Rate limit de automação #
Pergunta:
Mesmo que o evento seja válido, quantas operações automatizadas já disparei para este host dentro da política?
Um alerta novo pode ser legítimo e ainda assim não justificar outro diagnóstico pesado poucos minutos depois do anterior.
O alvo é validado primeiro #
Antes de criar qualquer chave Redis, o workflow normaliza o hostname e valida um padrão permitido.
Conceitualmente:
| |
Isso é um detalhe de segurança importante.
Rate limiting não deve ser a primeira barreira contra alvo inválido.
Se um hostname arbitrário consegue gerar chave e seguir para a automação, o controle de frequência está protegendo a coisa errada.
Duas dimensões de limite #
A implementação cria chaves lógicas separadas.
Uma representa o intervalo mínimo.
Outra representa o contador diário.
Conceitualmente:
| |
Os nomes reais não precisam ser publicados; o padrão é o que importa.
Isso permite responder duas perguntas diferentes:
| |
O contador diário usa TTL até a virada do dia #
O workflow calcula quanto tempo falta até a meia-noite no timezone operacional e usa esse valor como TTL do contador diário.
Assim a chave diária desaparece naturalmente depois da janela.
Fluxo:
| |
Isso evita precisar de um job separado limpando contadores antigos.
INCR é uma boa primitiva para esse problema #
Para o contador diário, o workflow usa incremento atômico no Redis.
Conceitualmente:
| |
Depois avalia:
| |
A vantagem é que dois eventos concorrentes não precisam fazer:
| |
como operações separadas.
O incremento acontece no Redis como uma única operação.
Intervalo mínimo reduz diagnósticos em rajada #
O segundo controle impede que um host passe novamente para AutoDiag antes de uma janela mínima.
Na implementação recuperada, essa janela era de duas horas.
Esse número não é universal.
Ele faz sentido dentro da política daquele ambiente.
Em outro cenário, poderia ser 15 minutos, 1 hora ou depender da severidade.
O importante é que o intervalo seja explícito e observável, não uma espera escondida em um node.
O limite diário era pequeno de propósito #
A política registrada permitia no máximo dois disparos automáticos por dia para o mesmo host.
Por quê?
Porque AutoDiag é diferente de simples notificação.
Mesmo um playbook de diagnóstico read-only consome:
- conexão SSH;
- processos no alvo;
- API do control plane;
- slot de execução do Semaphore;
- logs;
- tempo operacional;
- capacidade do próprio pipeline.
Quando o mesmo servidor já recebeu diagnósticos automáticos e continua alertando, pode ser mais útil escalar o problema do que repetir a mesma receita indefinidamente.
Fail-open foi uma decisão consciente #
Nos nodes Redis, erros eram tratados sem derrubar automaticamente todo o fluxo.
A lógica considerava falha/ausência de retorno do Redis e permitia seguir.
Isso caracteriza uma política fail-open para o rate limiter.
Ou seja:
| |
Essa escolha tem trade-off.
Vantagem #
Uma falha do Redis não impede diagnóstico de incidente real.
Risco #
Durante indisponibilidade do Redis, o mecanismo pode deixar passar mais execuções que o planejado.
Não existe escolha universal.
Para um AutoDiag read-only, fail-open pode ser aceitável.
Para uma automação destrutiva, talvez o desenho devesse ser fail-closed.
Rate limit precisa aparecer na observabilidade #
Se uma automação não rodou porque o limite foi atingido, isso não deveria desaparecer silenciosamente.
Eu registraria pelo menos:
| |
Assim o operador consegue distinguir:
| |
O desenho completo #
A arquitetura sanitizada fica assim:
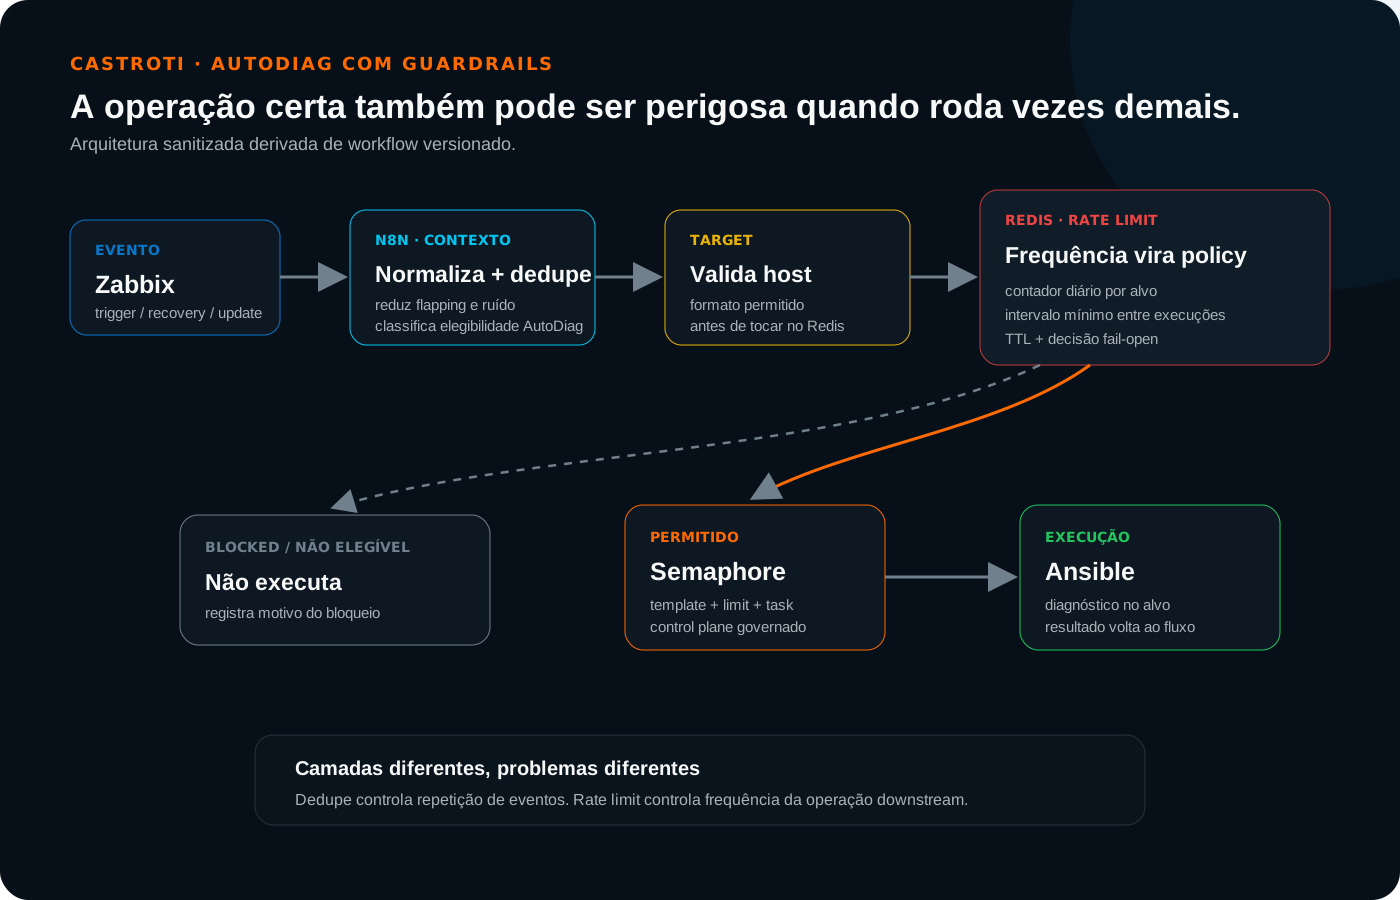
| |
O Redis não substitui a policy.
Ele é uma das camadas dela.
O que a fonte comprova #
O export versionado do workflow comprova:
- workflow ativo recebendo alertas Zabbix;
- classificação/dedupe anterior ao AutoDiag;
- identificação explícita de alertas elegíveis;
- validação do hostname antes do rate limit;
- chaves Redis por host;
- contador diário com
INCR; - TTL calculado até a virada do dia no timezone operacional;
- limite diário de 2 execuções;
- intervalo mínimo de 2 horas;
- tratamento fail-open quando Redis retorna erro/ausência;
- chamada ao caminho de AutoDiag somente depois dessas decisões.
O conteúdo público remove cliente, IDs de workflows, credenciais, endpoints, grupos, hosts reais e nomes internos.
O que essa evidência não prova #
Ela não prova automaticamente:
- quantos diagnósticos foram economizados por mês;
- percentual de redução de ruído;
- ROI;
- que dois disparos/dia é o valor ideal para outro ambiente;
- que fail-open é adequado para qualquer operação.
Essas são decisões de policy, não verdades universais.
Checklist para automação de diagnóstico por alerta #
| |
O principal aprendizado #
Quando Zabbix, n8n, Semaphore e Ansible entram no mesmo caminho, o risco não é apenas executar a operação errada.
Também existe o risco de executar a operação certa vezes demais.
Rate limiting transforma frequência em policy explícita.
E isso é parte do que separa uma automação útil de um loop automático com acesso à infraestrutura.
Me chama.
Manda o contexto, os sintomas e o que já foi testado. Bora organizar as evidências antes de sair mexendo.