- Castro/
- blog/
- n8n terminou como Succeeded, mas nenhuma task nasceu no Semaphore: sucesso do orquestrador não é sucesso downstream/
n8n terminou como Succeeded, mas nenhuma task nasceu no Semaphore: sucesso do orquestrador não é sucesso downstream
Como diagnosticar workflows que terminam verdes sem executar a operação downstream esperada, seguindo o payload, os branches e o contrato real da API até provar a criação da task.
Um workflow do n8n aparecia como:
| |
Mas a operação esperada no Semaphore não existia.
Nenhuma task tinha sido criada.
Esse é um tipo de falha perigoso porque a interface entrega uma sensação de sucesso enquanto o efeito principal do fluxo nunca aconteceu.
O problema não era “o Semaphore executou e falhou”.
Era anterior:
o workflow conseguia terminar sem chegar ao POST que criava a task.
Status do workflow mede o workflow #
Quando n8n marca uma execução como sucesso, isso significa que os nodes percorridos terminaram sem um erro não tratado.
Não significa automaticamente que:
- um e-mail foi recebido;
- uma task foi criada;
- um deploy aconteceu;
- uma mensagem foi entregue;
- um recurso cloud foi alterado.
Cada efeito downstream precisa de um critério próprio.
Primeiro: definir qual evento prova sucesso de negócio #
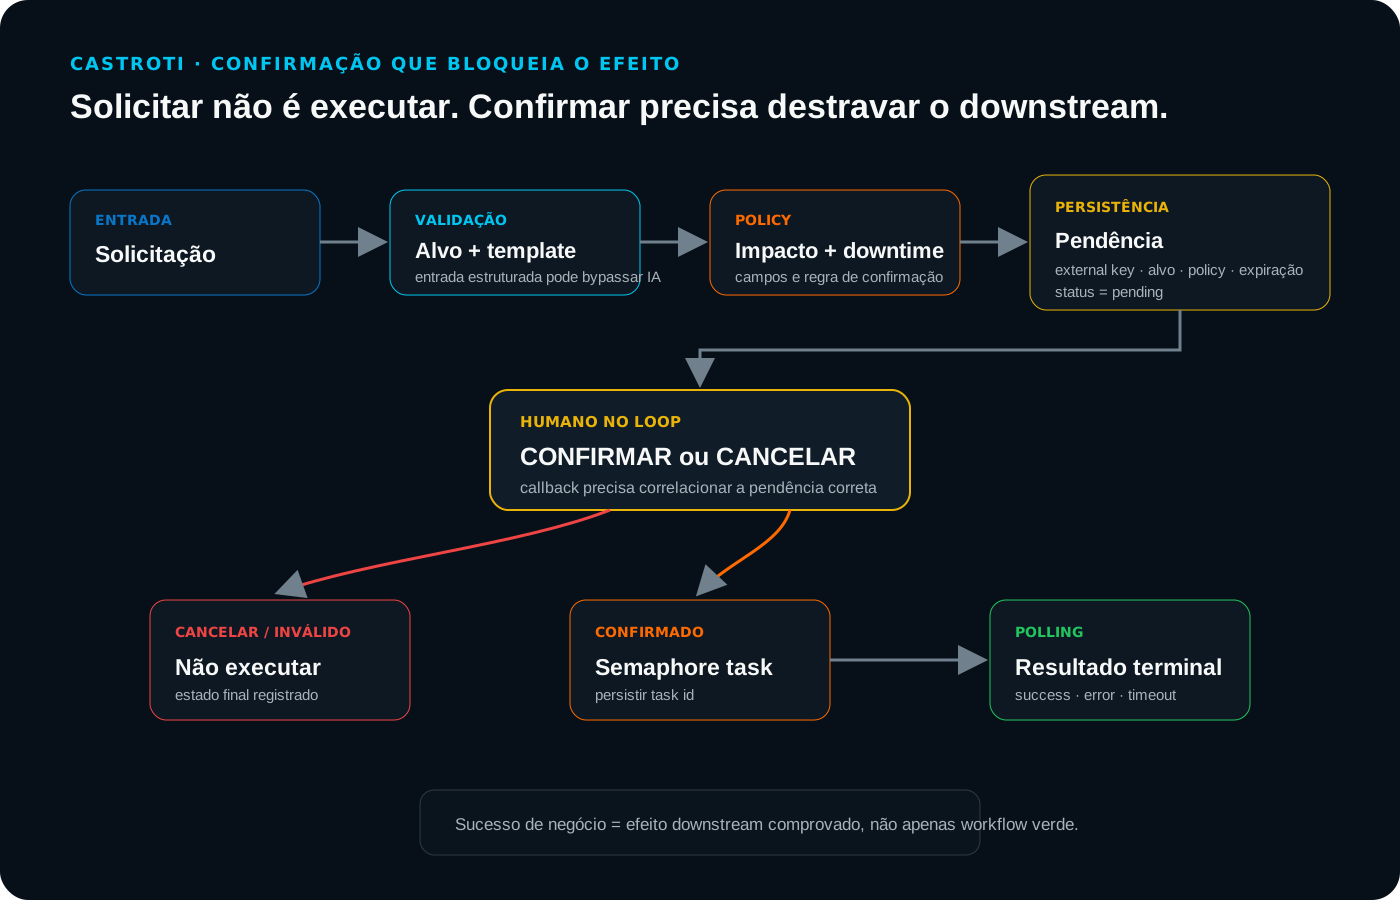
Nesse fluxo, o objetivo era criar uma task no Semaphore.
Então o evento mínimo de sucesso não deveria ser:
| |
E sim algo como:
| |
Idealmente, para operações longas:
| |
Seguir o caminho node por node #
A investigação recuperada mostrou alguns pontos em que a execução podia sair antes do Semaphore:
- normalização descartando campos importantes;
- branch de confirmação;
- classificação via IA;
- validação de template;
- validação de host;
- body incorreto no node HTTP.
Então o debug correto não era olhar apenas o último node verde.
Era perguntar:
| |
Um bug real: campos foram descartados na normalização #
No clone de homologação analisado, a normalização inicial preservava alguns campos, mas descartava valores operacionais que já tinham sido fornecidos na entrada.
Entre os campos adicionados depois à normalização estavam:
| |
Se template_id e limit desaparecem no começo, o restante do workflow pode tomar decisões como se o usuário nunca tivesse fornecido esses dados.
Nenhum erro de JavaScript é obrigatório para isso acontecer.
É uma falha de contrato de dados.
Outro bug: o body do POST não seguia o contrato validado #
O contrato da API do Semaphore foi testado separadamente por curl.
A estrutura sanitizada era equivalente a:
| |
A validação externa foi importante porque separou duas perguntas:
| |
de:
| |
Quando curl funciona e o workflow não cria task, a investigação migra para a construção/roteamento do workflow.
Não use mensagem fixa para um fluxo genérico #
Outro ajuste foi tornar a mensagem enviada ao Semaphore dinâmica conforme template e target.
Uma string hardcoded para uma operação específica pode:
- confundir auditoria;
- esconder qual receita foi acionada;
- indicar que o node foi copiado de outro fluxo sem revisar contrato.
Uma mensagem operacional deve carregar contexto suficiente para rastrear a task.
Node não executado é diferente de node executado com 2xx #
No histórico do n8n, eu separo:
Caso A — node HTTP não foi percorrido #
Problema de branch/condição/dados.
Caso B — node HTTP executou e retornou erro #
Problema de contrato, autenticação, validação ou serviço downstream.
Caso C — node HTTP retornou sucesso, mas não há task #
Confirmar semântica da resposta e endpoint; talvez 2xx não signifique criação efetiva ou a resposta tenha sido interpretada errado.
Caso D — task existe, mas falhou depois #
Agora a investigação pertence ao Semaphore/Ansible.
Misturar esses estados cria troubleshooting impreciso.
Instrumentar o fluxo com IDs e checkpoints #
Eu gosto de preservar um externalKey/correlation ID desde a entrada.
Depois registrar em pontos importantes:
| |
Isso permite correlacionar:
| |
Sem depender só de timestamp aproximado.
O node HTTP precisa validar resposta #
Não basta configurar “Continue On Fail” e deixar qualquer resposta seguir.
O fluxo deveria verificar explicitamente:
| |
Se a criação falhou, a execução de negócio deve ficar em estado de erro mesmo que o n8n consiga responder ao webhook de forma controlada.
“Responder ao usuário” e “executar operação” são estados independentes #
Um webhook pode responder 200 com algo como:
| |
Isso é perfeitamente válido.
O erro é a observabilidade interna tratar todo HTTP 200 do próprio workflow como se a automação tivesse acontecido.
Eu separaria estados:
| |
Teste fora do n8n reduz a área de suspeita #
Uma técnica que funcionou nesse caso foi validar o endpoint do Semaphore diretamente.
Com o contrato conhecido, o workflow pôde ser comparado com uma chamada mínima reproduzível.
Esse padrão vale para qualquer integração:
| |
Antes de desmontar o workflow inteiro, prove a API com um cliente simples.
O que a fonte sustenta #
O changelog e os registros da investigação documentam que:
- o clone de homologação podia terminar
Succeededsem chegar ao Semaphore; template_idelimiteram descartados na normalização anterior;- o body do node de envio estava incorreto;
- o contrato correto foi validado por chamada direta à API;
- a normalização passou a preservar campos operacionais;
- o body passou a ser dinâmico;
- host inválido passou a retornar erro sem ampliar escopo.
IDs reais de workflow, template e hostname foram omitidos.
Checklist para “verde sem efeito” #
| |
O principal aprendizado #
Orquestrador verde prova apenas que o caminho executado não terminou em erro não tratado.
Para automação operacional eu preciso de algo mais forte:
provar o efeito downstream que justificou executar o workflow.
Se nenhuma task nasceu no Semaphore, o job de negócio não teve sucesso — mesmo que o n8n esteja todo verde.
Me chama.
Manda o contexto, os sintomas e o que já foi testado. Bora organizar as evidências antes de sair mexendo.