- Castro/
- Cases/
- De playbooks concentrados a uma operação delegável: guardrails com Ansible e Semaphore/
De playbooks concentrados a uma operação delegável: guardrails com Ansible e Semaphore
Case anonimizado: como playbooks e conhecimento operacional passaram a ser expostos como tarefas governadas, com risco, alvo, Survey, validação e critérios de escalonamento.
Contexto #
O problema deste case não era falta de automação.
O Ansible já existia.
O problema era que saber executar a automação corretamente ainda dependia demais de contexto individual:
| |
Quando essas respostas estão só na memória de quem criou as receitas, a equipe tem YAML — mas ainda não tem uma operação realmente delegável.
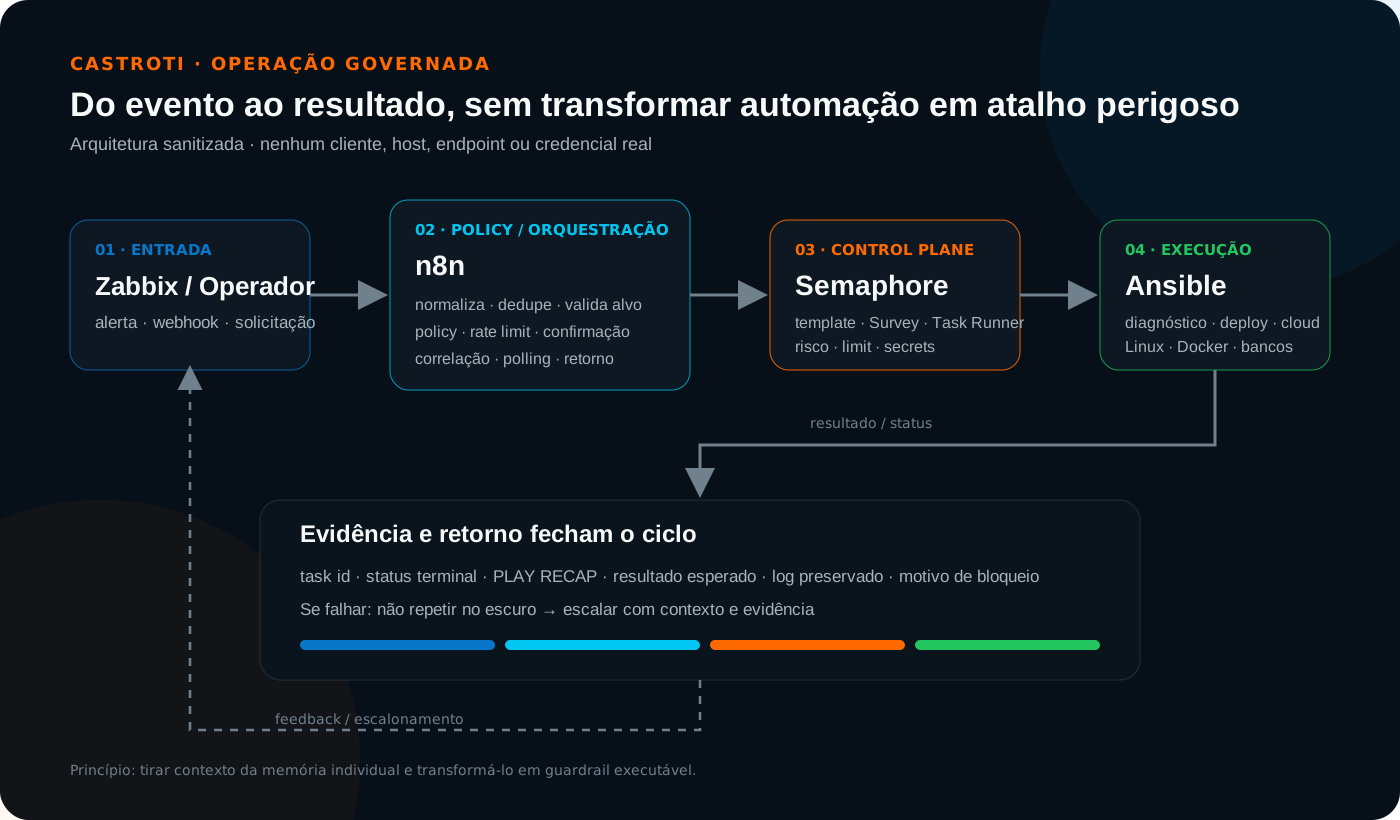
A evolução foi transformar esse conhecimento em um catálogo controlado no Semaphore e, depois, integrar partes da jornada com n8n e Zabbix.
O primeiro risco: executar a automação certa no alvo errado #
Uma receita pode estar tecnicamente correta e ainda causar problema se for executada no alvo errado ou em uma quantidade maior de hosts do que o pretendido.
Por isso o runbook passou a tratar cada operação com o mesmo conjunto de perguntas:
- qual é o risco;
- qual é o blast radius;
- a ação é reversível;
- quais são os pré-requisitos;
- quais parâmetros são obrigatórios;
- qual alvo deve ser informado;
- o que significa sucesso;
- em que situação o operador deve parar e escalar.
O objetivo era tirar decisões recorrentes da memória e colocá-las na própria interface operacional.
Antes de liberar um playbook, entender o playbook #
A documentação do projeto define uma regra que considero essencial:
não reorganizar fisicamente os playbooks antes de analisá-los.
Primeiro vem a classificação:
| |
Só depois a receita vira template operacional.
Isso evita um tipo de refatoração perigosa: melhorar a organização do repositório e, no processo, mudar comportamento de automação que já era usada em produção.
Risco virou parte do catálogo #
As tarefas passaram a ser avaliadas em níveis como:
| |
Uma tarefa ainda desconhecida não deveria ser liberada só porque o nome parece inofensivo.
A classificação funciona como sinalização para quem executa e como gate para quem mantém a plataforma.
Task Runner separa executar de editar #
Outro ponto importante foi separar o papel de quem executa uma receita aprovada do papel de quem administra a plataforma.
O operador Task Runner não precisa editar:
- repositório;
- inventory;
- variable groups;
- key store;
- template;
- credenciais.
Isso reduz a necessidade de entregar acesso amplo apenas para que alguém consiga executar uma rotina conhecida.
Não elimina risco humano.
Mas reduz muito o espaço entre “preciso fazer esta tarefa” e “tenho poder para alterar a receita que será executada”.
Survey Variables viraram a interface da receita #
Em vez de exigir que o operador monte comandos Ansible, os templates expõem apenas os campos que aquela operação precisa.
Exemplos:
| |
Isso transforma parâmetros internos em um contrato operacional mais compreensível.
A pessoa que executa não precisa conhecer a estrutura inteira do playbook para preencher o que a tarefa realmente exige.
Limit precisa ser explícito #
Uma das regras mais importantes do runbook é preencher o alvo quando o template oferece Limite.
Em inventory amplo, campo vazio pode ampliar o alcance da execução.
Então a proteção passa a acontecer antes do botão de Run:
| |
Esse é um exemplo de guardrail simples que vale mais do que uma mensagem genérica de “cuidado”.
PLAY RECAP também virou gate operacional #
O fim da execução não é só uma tela verde.
O runbook estabelece uma regra prática:
| |
Isso reduz o hábito perigoso de tentar a mesma automação várias vezes sem entender o primeiro erro.
Diagnóstico antes de mudança #
Parte importante das receitas mapeadas é de leitura e diagnóstico:
- health check;
- PostgreSQL;
- Redis;
- logs de containers;
- eventos cloud;
- Zabbix;
- inventário;
- coleta pré-migração.
Esse desenho permite que a primeira resposta a um problema seja coletar contexto em vez de reiniciar alguma coisa.
É especialmente útil para operação N1: o runbook consegue dizer qual diagnóstico executar e quando o resultado deve ser escalado, sem transformar o primeiro nível em um conjunto de botões de restart.
Depois, Zabbix e n8n ampliaram o modelo #
Em alguns fluxos, a execução não começa mais por alguém abrindo o Semaphore.
Um alerta pode seguir por uma camada de orquestração:
| |
Isso não significa “todo alerta executa alguma coisa”.
É o contrário: a camada intermediária existe para decidir quando o evento não deve virar execução.
Confirmação precisa bloquear a ação #
Para operações que exigem confirmação humana, a evolução do fluxo chegou a um modelo persistente:
| |
Isso é diferente de mandar uma mensagem de “confirmação” e continuar a automação independentemente da resposta.
A confirmação faz parte do estado da operação.
Nem toda automação pode ser liberada #
O inventário contém tarefas de riscos muito diferentes.
Diagnóstico read-only não deve ter a mesma política de um restart, deploy, resize cloud ou ação destrutiva.
Por isso algumas receitas podem ser disponibilizadas a operadores; outras continuam restritas.
Ter um playbook não significa ter um template aprovado.
Resultado comprovável #
O que a documentação e os artefatos disponíveis permitem afirmar é que a operação ganhou uma camada explícita de governança:
- catálogo;
- classificação de risco;
- alvo/blast radius;
- Survey Variables;
- separação Task Runner/admin;
- critérios de validação;
PLAY RECAPcomo evidência;- regra de escalonamento;
- integração com diagnóstico/orquestração em fluxos específicos.
Existe uma percepção operacional de ganho maior em delegação e escala, mas percentuais e quantidade total de servidores só devem virar números públicos depois de uma medição reproduzível.
O que eu faria diferente se começasse hoje #
Eu trataria desde o primeiro playbook três coisas como metadados obrigatórios:
| |
E acrescentaria um quarto campo:
| |
Isso facilitaria transformar uma coleção histórica de automações em catálogo sem precisar redescobrir o contexto de cada receita depois.
Projeto relacionado #
A arquitetura completa está documentada em Ecossistema operacional com Ansible, Semaphore, n8n e Zabbix.
Tecnologias #
Ansible · Semaphore · n8n · Zabbix · Redis · PostgreSQL · AWS · OCI · Docker · Shell
Me chama.
Manda o contexto, os sintomas e o que já foi testado. Bora organizar as evidências antes de sair mexendo.